
Une nouvelle IA puissante prédit comment plus de 1 000 maladies peuvent se dérouler dans la vie d'une personne, ouvrant des portes pour la prévention de la précision, la planification des politiques et l'innovation de santé consciente du biais.
Étude: Apprendre l'histoire naturelle des maladies humaines avec des transformateurs génératifs. Crédit d'image: Song_about_Summer / Shutterstock
Dans une étude récente Publié dans la revue Natureles chercheurs ont développé un modèle d'apprentissage automatique qui a utilisé des données de santé à grande échelle pour prédire la progression de 1 256 maladies distinctes de niveau 3 de la CIM-10 basées sur des patients antécédents médicaux.
Le modèle a démontré une précision prédictive comparable aux outils existants qui analysent les maladies individuelles. Il a montré un potentiel de simulation de trajectoires de santé futures sur une période pouvant aller jusqu'à deux décennies et a fourni des informations sur les risques et les comorbidités personnalisées.
Sommaire
Un besoin de modèles de maladies complexes
La progression de la maladie humaine implique des périodes de santé, de maladies aiguës et de maladies chroniques, apparaissant souvent comme des grappes de comorbidités influencées par la génétique, le mode de vie et les facteurs socioéconomiques.
Comprendre ces modèles est crucial pour fournir des soins de santé personnalisés, fournir des conseils sur le mode de vie et mettre en œuvre des programmes de dépistage précoces efficaces. Cependant, les algorithmes traditionnels sont principalement conçus pour les maladies uniques et ne peuvent pas saisir la complexité de plus de 1 000 problèmes de santé reconnus.
Cette limitation devient particulièrement importante dans le contexte des populations vieillissantes, où la charge des maladies telles que le cancer, le diabète, les maladies cardiovasculaires et la démence devraient augmenter considérablement au cours des prochaines décennies. La modélisation avec précision des trajectoires de la maladie est donc vitale à la fois pour la planification des soins de santé et la politique économique.
Intelligence artificielle, en particulier les modèles de langues (LLMS), fournit une solution prometteuse. Ces modèles excellent dans l'apprentissage des dépendances à travers les séquences de données, un peu comme la prévision des maladies basées sur des événements de santé antérieurs.
Inspirés par cette analogie, les chercheurs ont développé des modèles basés sur des transformateurs pour prédire des conditions spécifiques, avec encourageant les premiers résultats. Pourtant, malgré ces avancées, un modèle vraiment complet et génératif capable de simuler le spectre complet de la multimorbidité au fil du temps n'a pas été systématiquement évalué.
Développer un modèle de données à grande échelle
Les chercheurs ont créé Delphi-2M, un modèle basé sur un transformateur, pour prédire les trajectoires de la maladie à vie. Contrairement aux modèles de langue qui traitent les mots, Delphi-2M a travaillé avec les codes de diagnostic de la dixième révision de la classification internationale des maladies (ICD-10), ainsi que la mort, le sexe, IMCet des facteurs de style de vie tels que le tabagisme et la consommation d'alcool.
Pour combler les lacunes dans les dossiers médicaux, l'équipe a inséré des jetons artificiels «sans événement». Il comprenait des jetons sexuels et de style de vie, avec un vocabulaire couvrant des codes de maladie, des niveaux de style de vie, du sexe, du non-événement et des jetons de rembourrage (environ 1 270 au total).
La formation était basée sur des dossiers de santé à grande échelle de la biobanque britannique, comprenant 402 799 participants à la formation, 100 639 pour la validation et 471 057 pour des tests longitudinaux. Pour tester la généralisation, le modèle a également été validé sur les données de 1,93 million de personnes danois.
Plusieurs modifications ont adapté le modèle de base aux données de santé: remplacer le codage positionnel par un codage d'âge continu, l'ajout d'une tête de sortie pour prédire un événement de temps à neutraliser et modifier les masques d'attention pour empêcher les jetons en même temps de s'influencer mutuellement.
Delphi-2M pourrait estimer les risques pour plus de 1 000 maladies, prévoir le calendrier des diagnostics et simuler des trajectoires de santé complètes. Les performances ont été optimisées par le réglage de l'hyperparamètre, résultant en un modèle de paramètres de 2,2 m qui combinait la précision prédictive avec une capacité générative, offrant une nouvelle approche de la modélisation de la multimorbidité et de la progression à long terme de la santé.
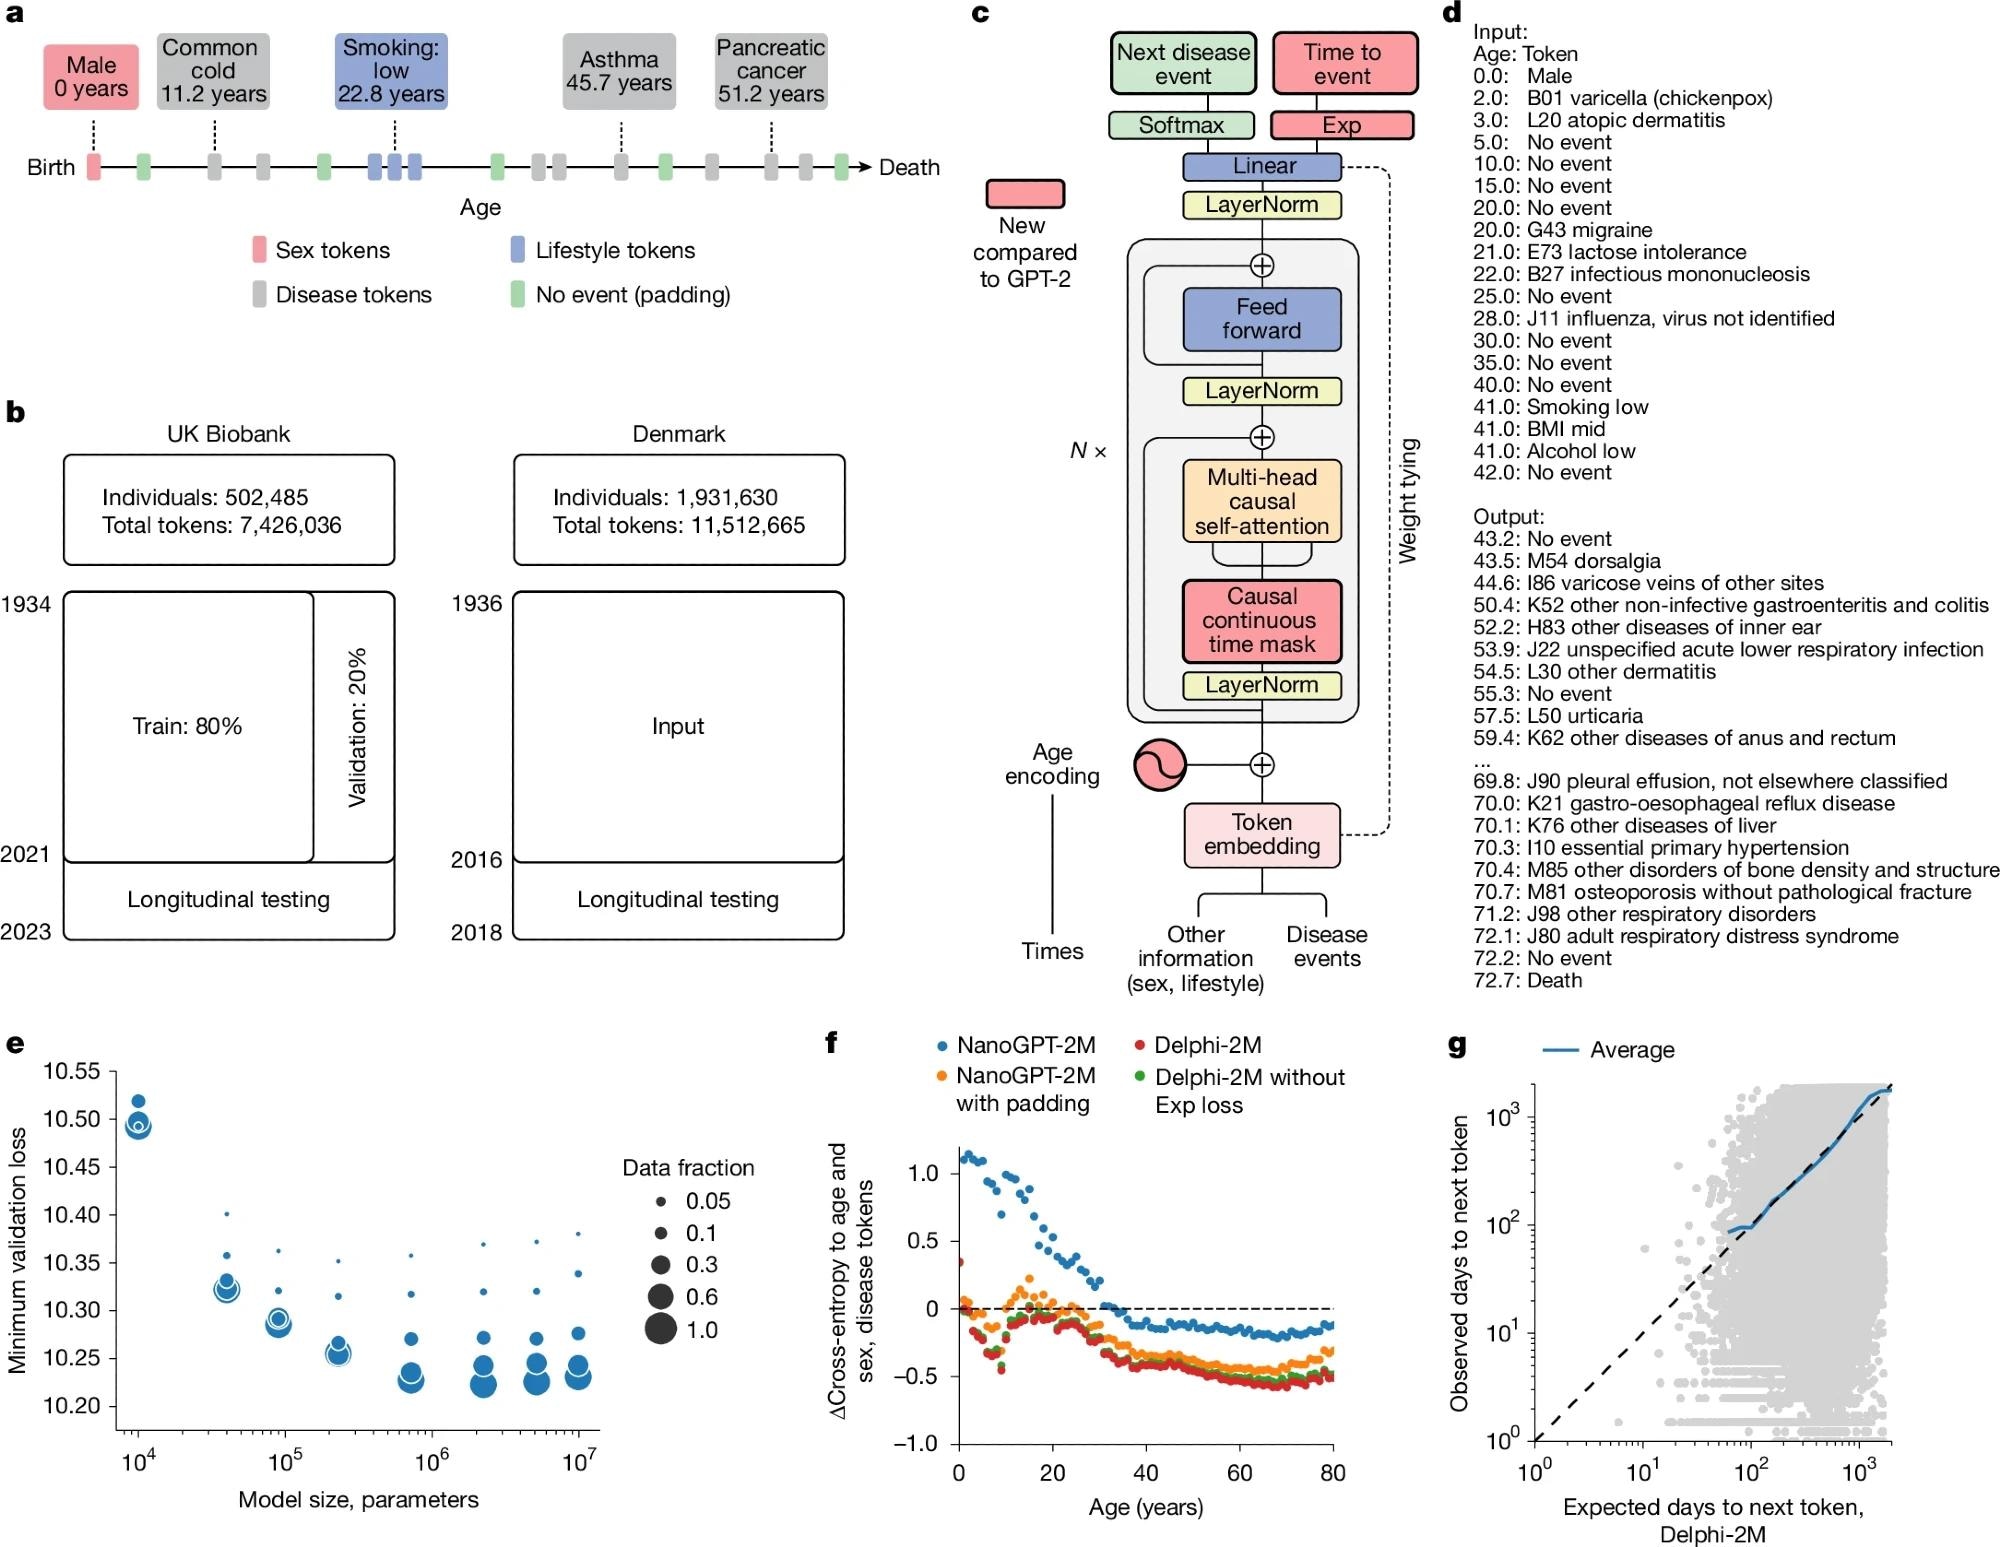
unSchéma des trajectoires de santé basées sur les diagnostics de la CIM-10, le mode de vie et les jetons de rembourrage sains, chacun enregistré à un âge distinct. bDonnées de formation, de validation et de test dérivées de la biobanque britannique (à gauche) et des registres de la maladie danoise (à droite). cL'architecture du modèle Delphi. Les éléments rouges indiquent des changements par rapport au modèle GPT-2 sous-jacent. «N ×» désigne l'application du bloc de transformateur séquentiellement n fois. dExemple d'entrée de modèle (invite) et de sortie (échantillons) comprenant (token) paires. eÉchelle des lois de Delphi, montrant la perte optimale de validation en fonction des paramètres du modèle pour différentes tailles de données d'entraînement. fRésultats de l'ablation mesurés par les différences entre l'entropie croisée par rapport à une base de référence basée sur l'âge et le sexe) pour différents âges (axe x). gLa précision du temps prévu pour l'événement. Les temps observés (axe y) et attendus (axe x) vers des événements sont indiqués pour chaque prédiction de la prochaine fois (points gris). La ligne bleue montre la moyenne à travers les bacs consécutifs de l'axe x.
Évaluer les performances du modèle
Les performances de Delphi-2M ont été évaluées en utilisant des données sur la santé jusqu'à 60 ans, contre 63 622 participants à la biobanque britannique. Le modèle a généré des trajectoires de santé simulées et les a comparées avec des résultats tangibles.
Les prédictions des taux de maladie à 70 et 75 modèles observés sont étroitement adaptés, confirmant sa capacité à capturer les tendances d'incidence au niveau de la population. Tandis que la précision prédictive a diminué sur des horizons de temps plus longs, à partir d'une moyenne AUC D'environ 0,76 à environ 0,70 à 10 ans, Delphi-2M a toujours surperformé les modèles basés uniquement sur l'âge et le sexe.
Le modèle distinguait efficacement les risques entre les sous-groupes définis par le mode de vie ou les maladies antérieures, soutenant sa valeur pour le profilage des risques personnalisés.
Surtout, Delphi-2M pourrait également générer des trajectoires de santé synthétiques qui reflétaient les schémas de la maladie du monde réel sans reproduire les enregistrements individuels. Un modèle formé uniquement sur ces données synthétiques a conservé une grande partie des performances de l'original, ne montrant qu'une baisse de trois points dans l'AUC. Cela met en évidence des applications potentielles pour la recherche préservant la confidentialité.
Pour interpréter les prédictions, les chercheurs ont examiné l'espace d'intégration, qui a révélé des grappes de maladies conformes à ICD-10 Les chapitres et ont montré comment des diagnostics spécifiques ont façonné les résultats, tels que le fort impact du cancer du pancréas sur la mortalité.
La validation externe sur les données danoises a confirmé la généralisation, avec une moyenne AUC d'environ 0,67, mais avec une modeste chute de performances. Enfin, l'étude a reconnu ses limites, y compris les biais dans le processus de recrutement de biobanque britannique et les modèles de données manquantes.
Conclusions
L'étude a introduit Delphi-2M, un modèle basé sur GPT capable de prédire et de simuler la progression de plusieurs maladies au fil du temps. Par rapport aux modèles basés sur une maladie unique ou à base de biomarqueurs, Delphi-2M a montré une forte précision dans la prévision des risques pour la santé dans plus de 1 000 conditions.
Pour le risque de diabète, cependant, il a obtenu une performance inférieure à celle du marqueur unique HbA1c Approche, bien qu'avec seulement une baisse modeste des performances lorsqu'elle a été testée sur les données danoises.
Sa capacité à échantillonner les trajectoires futures synthétiques permet d'estimer les charges de maladies à long terme et la création d'ensembles de données préservant la confidentialité. Le modèle a également mis en évidence les modèles de comorbidités et les influences temporelles des maladies, telles que les risques de mortalité persistants du cancer, et a atteint un AUC d'environ 0,97 pour prédire la mort.
Cependant, plusieurs limitations ont été notées. Les prédictions reflétaient les biais dans les données biobanques britanniques, y compris les effets de bénévolat sains, les biais de recrutement et les modèles de manque de manque. Des différences ont également été observées dans l'ascendance et les groupes socio-économiques. Surtout, le modèle capture les associations statistiques mais pas les relations causales, ce qui limite son utilisation clinique directe.
Dans l'ensemble, Delphi-2M démontre la promesse de modèles basés sur les transformateurs pour la prédiction des risques personnalisés, la planification des soins de santé et la recherche biomédicale. Les améliorations futures pourraient intégrer des données multimodales, soutenir la prise de décision clinique et l'élaboration des politiques d'aide dans les populations vieillissantes.
