
Dans une étude récente publiée dans la revue Réseau JAMA ouvert, les chercheurs ont évalué deux grands modèles de langage (LLM) ChatGPT formés pour répondre aux questions de la banque de questions de l’American Board of Psychiatry and Neurology. Ils ont comparé ces résultats pour des questions d’ordre inférieur et supérieur à ceux d’étudiants en neurologie humaine. Ils ont constaté que l’un des deux modèles surpassait considérablement les scores humains moyens aux questions (85 % contre 73,8 %), réussissant ainsi un examen d’entrée généralement difficile à passer. Ces résultats mettent en évidence les progrès récents des LLM et montrent comment, avec des ajustements mineurs, ils pourraient devenir des ressources clés pour les applications cliniques en neurologie.
Étude : Performance de grands modèles de langage lors d’un examen de type jury de neurologie. Crédit d’image : PopTika/Shutterstock
Sommaire
Ils deviennent plus intelligents !
L’apprentissage automatique (ML) et d’autres algorithmes d’intelligence artificielle (IA) sont de plus en plus adoptés dans des domaines auparavant réservés aux humains, notamment la médecine, l’armée, l’éducation et la recherche scientifique. Avec les progrès récents en matière de puissance de calcul et le développement de modèles d’IA « plus intelligents », ces algorithmes d’apprentissage profond sont désormais largement utilisés en neurologie clinique pour des tâches allant du diagnostic neurologique au traitement et au pronostic.
Récemment, des architectures d’IA basées sur des transformateurs – des algorithmes d’IA formés sur de vastes ensembles de données de 45 téraoctets ou plus – aident et parfois même remplacent les humains dans des rôles traditionnellement uniquement humains, y compris la neurologie. La grande quantité de données de formation, associée à un code continuellement amélioré, permet à ces modèles de présenter des réponses, des suggestions et des prédictions à la fois logiques et précises. Deux algorithmes principaux basés sur la plate-forme populaire ChatGPT ont jusqu’à présent été développés : LLM 1 (ChatGPT version 3.5) et LLM 2 (ChatGPT 4). Le premier est moins exigeant en termes de calcul et beaucoup plus rapide dans le traitement des données, tandis que le second est contextuellement plus précis.
Même si des preuves informelles plaident en faveur de l’utilité de ces modèles, leurs performances et leur précision ont rarement été testées dans un cadre scientifique. Les preuves limitées existantes proviennent de recherches sur les performances du LLM 1 lors de l’examen de licence médicale aux États-Unis (USMLE) et lors des examens d’ophtalmologie, la version LLM 2 n’étant jusqu’à présent pas validée.
À propos de l’étude
Dans la présente étude, les chercheurs visaient à comparer les performances des LLM 1 et 2 à celles des étudiants en neurologie humaine lors d’examens écrits de type jury. Cette étude transversale est conforme aux directives de renforcement du reporting des études observationnelles en épidémiologie (STROBE) et utilise un examen du jury de neurologie comme indicateur des performances des LLM 1 et 2 dans des examens médicaux humains hautement techniques.
L’étude a utilisé des questions de la banque de questions publique de l’American Board of Psychiatry and Neurology (ABPN). La banque contient 2 036 questions, dont 80 ont été exclues car basées sur des vidéos ou des images présentées. LLM 1 et LLM 2 ont été obtenus à partir de sources en ligne contenues dans le serveur (ChatGPT 3.5 et 4, respectivement) et ont été formés jusqu’en septembre 2021. Des comparaisons humaines ont été effectuées à l’aide de données réelles provenant d’itérations précédentes de l’examen d’entrée au conseil d’administration de l’ABPN.
Notamment, lors des évaluations, les modèles pré-entraînés LLM 1 et 2 n’avaient pas accès aux ressources en ligne pour vérifier ou améliorer leurs réponses. Aucun ajustement ou réglage précis du modèle spécifique à la neurologie n’a été effectué avant les tests sur le modèle. Le processus de test consistait à soumettre les modèles à 1 956 questions à choix multiples, chacune comportant une bonne réponse et entre trois et cinq éléments de distraction. Toutes les questions ont été classées en questions d’ordre inférieur (compréhension de base et mémoire) et d’ordre supérieur (basées sur l’application, l’analyse ou la réflexion évaluative) selon la taxonomie Bloom pour l’apprentissage et l’évaluation.
Les critères d’évaluation considéraient un score de 70 % ou plus comme note de passage minimale pour l’examen. Les modèles ont été testés pour la reproductibilité des réponses via 50 requêtes indépendantes conçues pour sonder les principes d’auto-cohérence.
« Pour l’analyse de grande dimension des représentations de questions, les plongements de ces questions ont été analysés. Ces représentations vectorielles numériques englobent l’essence sémantique et contextuelle des jetons (dans ce contexte, les questions) traités par le modèle. La source de ces plongements sont les paramètres ou poids du modèle, qui sont utilisés pour coder et décoder les textes pour l’entrée et la sortie.
L’analyse statistique consistait en une comparaison à variable unique, spécifique à un ordre, entre les performances des modèles et les résultats humains antérieurs à l’aide d’un chi carré (χ2) test (avec corrections de Bonferroni pour 26 sous-groupes de questions identifiés).
Résultats de l’étude
Le LLM 2 a montré la meilleure performance de toutes les cohortes testées, obtenant un score de 85,0 % (1 662 questions sur 1 956 ont répondu correctement). En comparaison, le LLM 1 a obtenu un score de 66,8 % et les humains une moyenne de 73,8 %. La performance du modèle s’est avérée la plus élevée dans les questions d’ordre inférieur (71,6 % et 88,5 %, respectivement, pour les modèles 1 et 2).
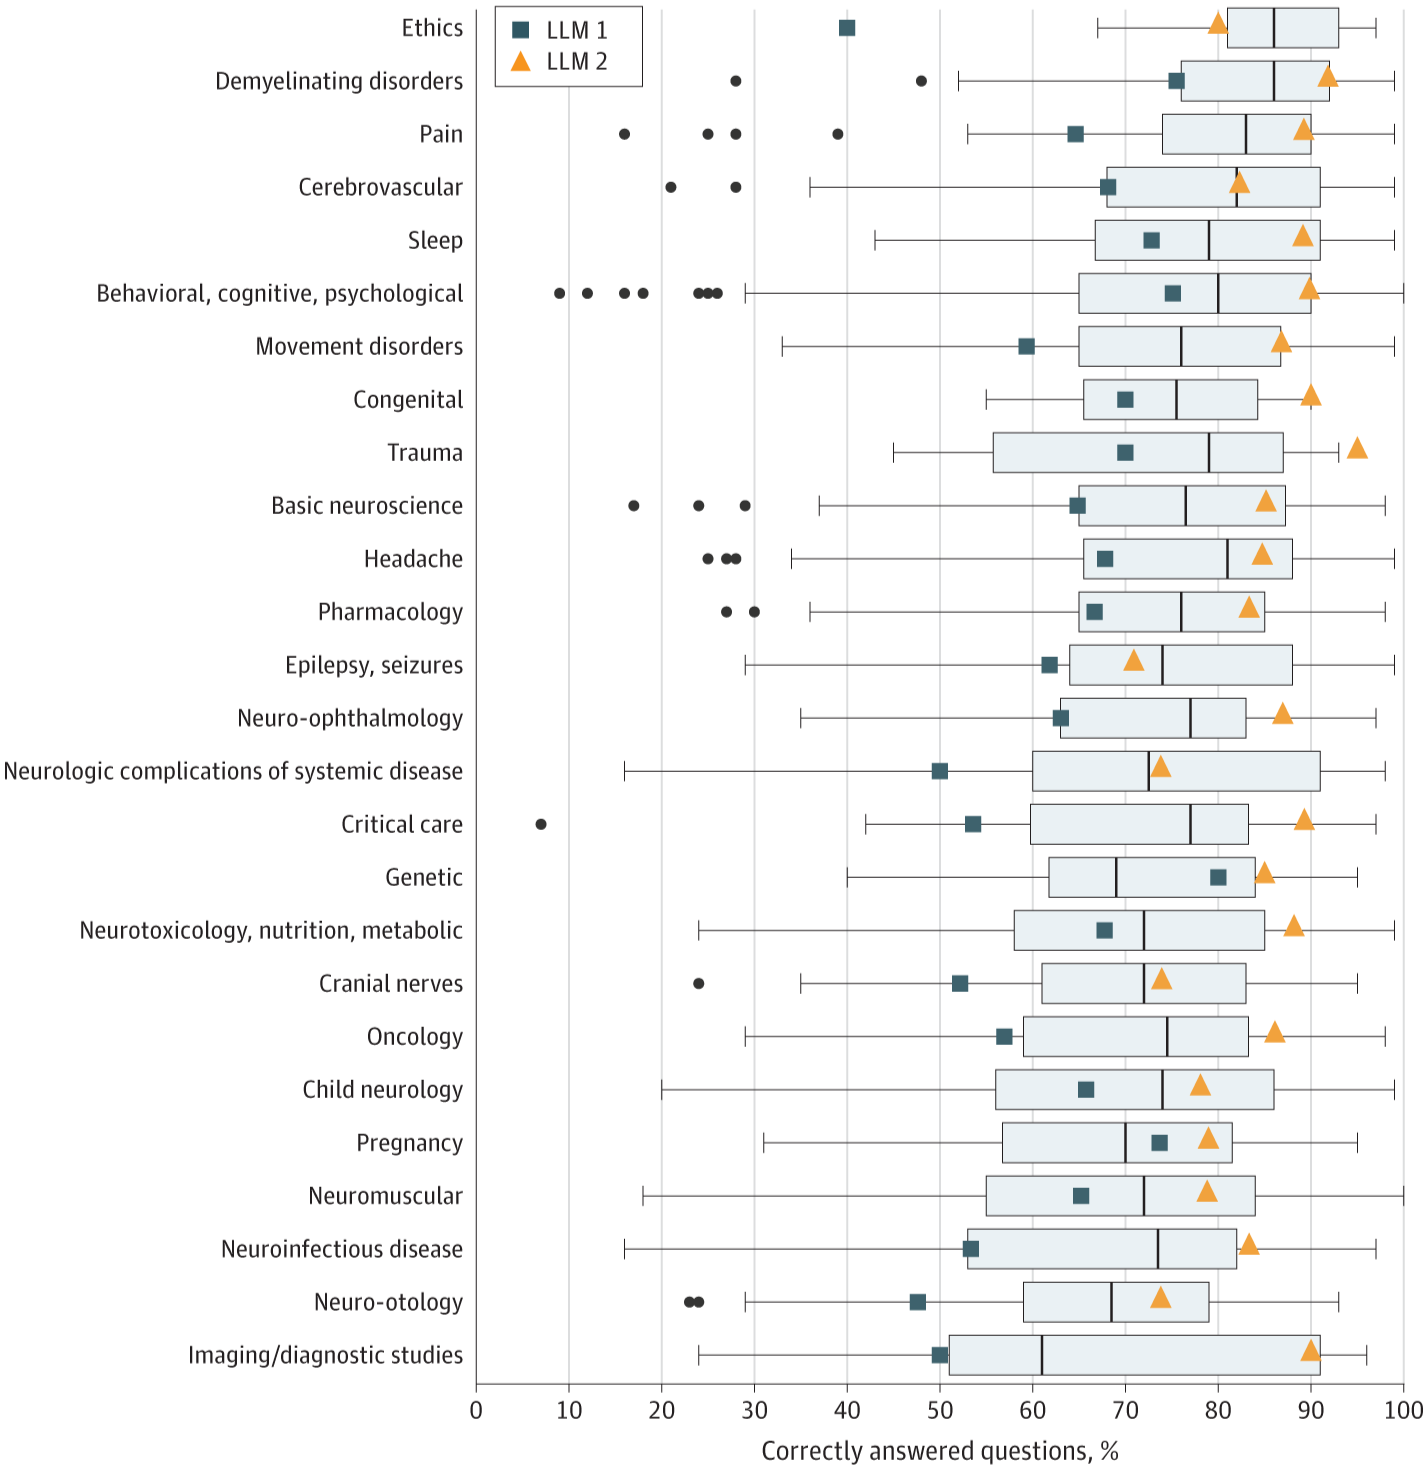 Les boxplots illustrent la distribution des scores des utilisateurs humains, la ligne noire indiquant la médiane, les bords des cases indiquant les premier et troisième quartiles, et les moustaches indiquant la valeur la plus grande et la plus petite ne dépassant pas 1,5 × IQR à partir des bords inférieur et supérieur. Les points indiquent les valeurs aberrantes. LLM indique un grand modèle de langage.
Il est intéressant de noter que la précision d’ordre inférieur du LLM 1 était similaire à celle des étudiants humains (71,6 % contre 73,6 %), mais significativement inférieure pour les questions d’ordre supérieur (62,7 % contre 73,9 %). Cependant, à peine une demi-génération plus tard, les améliorations de l’algorithme ont permis à la version 4 de ChatGPT de surpasser les étudiants humains en termes de précision, à la fois inférieure et supérieure.
« Dans la catégorie comportementale, cognitive et psychologique, le LLM 2 a surpassé à la fois le LLM 1 et les utilisateurs moyens de la banque de tests (LLM 2 : 433 sur 482). [89.8%]; LLM 2 : 362 sur 482 [75.1%]; utilisateurs humains : 76,0 % ; P < 0,001). Le LLM 2 a également montré des performances supérieures dans des domaines tels que les neurosciences fondamentales, les troubles du mouvement, la neurotoxicologie, la nutrition, le métabolisme, l'oncologie et la douleur par rapport au LLM 1, alors que ses performances s'alignaient sur la moyenne des utilisateurs humains.
Conclusions
Dans la présente étude, les chercheurs ont évalué les performances de deux LLM ChatGPT lors des examens neurologiques. Ils ont constaté que le dernier modèle surpassait considérablement le modèle précédent et les étudiants en neurologie humaine pour les questions d’ordre inférieur et supérieur. Bien qu’ils montrent de plus grandes forces dans les questions basées sur la mémoire par rapport à celles nécessitant la cognition, ces résultats mettent en évidence le potentiel de ces modèles pour aider, voire remplacer les experts médicaux humains dans des rôles non critiques.
Notamment, ces modèles n’ont pas été modifiés à des fins neurologiques et n’ont pas non plus eu accès à des ressources en ligne constamment mises à jour, ce qui pourrait améliorer encore davantage les gains de performances entre eux et leurs créateurs humains. En un mot, les LLM en IA deviennent plus intelligents à un rythme sans précédent.
Sur une note joviale, l’auteur de cet article (qui n’a aucune affiliation avec les auteurs de l’étude) recommande que les cyborgs voyageant dans le temps soient préparés pour un déploiement rapide comme garantie si et quand les LLM réalisent à quel point ils sont intelligents !
