Les chercheurs ont testé un seul implant cortical, se demandant si les tentatives de parole et de gestes corporels pouvaient être décodées ensemble et traduites en un avatar personnalisé du corps entier.
Étude : Décodage simultané de la parole et des gestes pour la communication multimodale dans les paralysies. Crédit d’image : Kittyfly
Dans une étude récente publiée dans la revue Neurosciences naturellesun groupe de chercheurs a étudié si une seule électrocorticographie à haute densité (ECoG) pourrait simultanément décoder les tentatives de parole et de gestes et prendre en charge une communication expressive en temps réel via un avatar virtuel personnalisé chez les personnes atteintes de paralysie sévère.
Sommaire
Arrière-plan
Comment l’activité cérébrale peut-elle révéler des tentatives de parole ou de geste alors qu’une paralysie sévère limite les mouvements ? Les accidents vasculaires cérébraux et les maladies neurodégénératives peuvent altérer la parole et les mouvements corporels, limitant ainsi la participation sociale et la qualité de vie.
Interfaces cerveau-ordinateur (BCI) visent à restaurer les fonctions perdues en traduisant l’activité neuronale en commandes pour des appareils externes. Des recherches antérieures du BCI ont décodé la parole et d’autres mouvements séparément. La communication naturelle combine souvent le langage parlé et les gestes. Le cortex sensorimoteur (SMC) contient des représentations de plusieurs régions du corps, tandis que l’ECoG peut enregistrer l’activité neuronale sur ce territoire.
À propos de l’étude
Trois participants présentant de graves troubles de la parole et des troubles moteurs ont été inscrits au BCI Restoration of Arm and Voice (BRAVO) essai clinique. Deux ont eu un accident vasculaire cérébral et un, une sclérose latérale amyotrophique (SLA). Chacun a reçu un réseau ECoG haute densité de 253 électrodes implanté sous-dural sur l’hémisphère gauche, ciblant les zones vocales et motrices.
L’activité neuronale a été enregistrée lors de plusieurs mouvements corporels et utilisée pour la cartographie et le décodage multi-effecteurs initiaux chez les trois participants ; après le retrait de Bravo-3, les principales expériences simultanées de parole, de gestes et d’avatar impliquaient Bravo-1r et Bravo-6. Les stratégies de tentative reflétaient les capacités résiduelles : Bravo-1r et Bravo-3 tentaient de parler silencieusement, tandis que Bravo-6 tentait de parler avec vocalisation ; les mouvements corporels ont été tentés, peu tentés ou imaginés en fonction des capacités des participants.
Dans la tâche de copie, les cibles étaient présentées sous forme de texte, d’animations de mouvement ou les deux, suivis d’un signal de départ et d’un intervalle entre les essais de 2 secondes. Un paradigme de conversation indiquée a également été utilisé avec Bravo-1r et Bravo-6.
Les signaux ont été traités pour extraire une activité gamma élevée (HGA; 70–150 Hz) et les signaux basse fréquence (EPA; 1 à 100 Hz). Des décodeurs de réseaux neuronaux récurrents convolutifs spécifiques aux participants ont été formés sur des essais isolés, des essais simultanés ou les deux. Une classe de repos a utilisé des essais de vrai repos et de modalités opposées. Les performances ont été évaluées hors ligne avec une validation croisée et des comparaisons statistiques entre les conditions de décodage. Des décodeurs parallèles en temps réel contrôlaient un avatar virtuel personnalisé sur tout le corps. Les participants ont donné leur consentement éclairé et l’approbation institutionnelle a été obtenue.
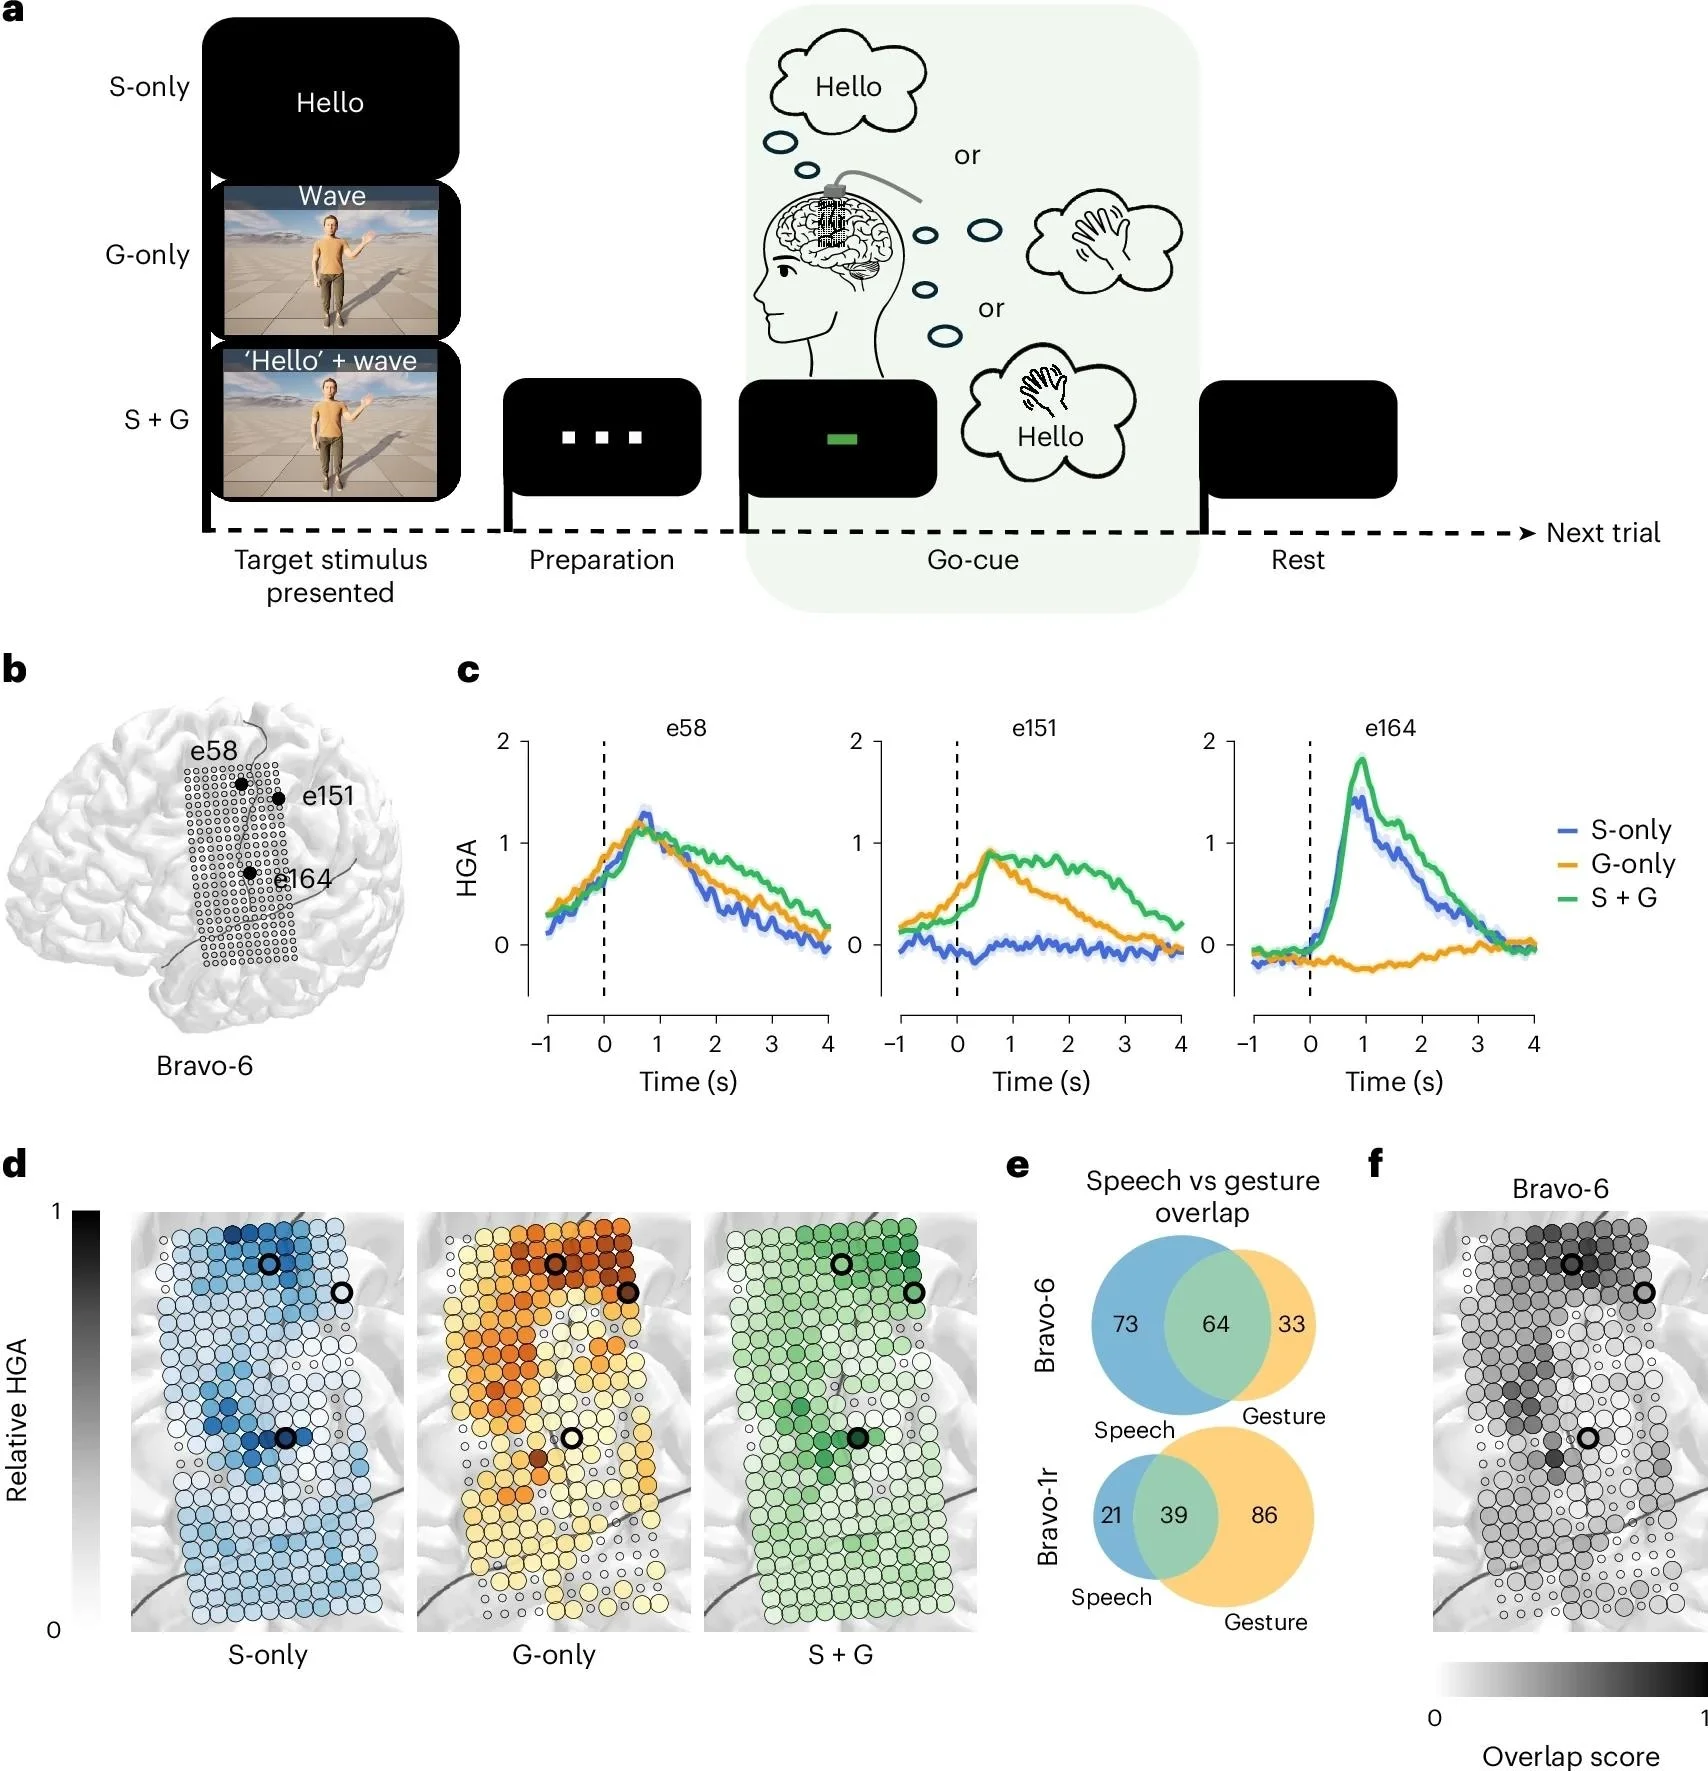
unStructure d’essai pour trois paradigmes de tâches – S-only (stimulus texte), G-only (stimulus avatar animé) et S + G simultanés (stimulus texte et avatar animé). La présentation du stimulus est suivie d’un compte à rebours jusqu’à un signal de départ, lorsque le participant est invité à tenter la cible. bÉlectrodes en surbrillance (e58, e151 et e164) superposées sur le cerveau de Bravo-6. cHGA (moyenne ± sem) pour les trois mêmes exemples d’électrodes lors des essais S uniquement (bleu), des essais G uniquement (orange) et des essais S + G (vert) alignés sur le signal de départ. dCartes spatiales du HGA relatif lors des essais S-only, G-only et S + G pour Bravo-6. Les électrodes encerclées correspondent à celles étiquetées en b et tracé dans c. eDiagrammes de Venn du chevauchement entre les électrodes présentant une activité neuronale significative lors des essais S uniquement et des essais G uniquement (Bravo-6, en haut ; Bravo-1r, en bas). fLa carte de chevauchement met en évidence les électrodes significativement actives dans les conditions de parole et de geste pour Bravo-6. Des scores de chevauchement plus élevés indiquent des électrodes avec une modulation HGA relative plus forte pendant les deux comportements, tandis que des scores de chevauchement plus faibles indiquent une modulation plus faible dans l’une ou les deux conditions. Les électrodes non significatives sont représentées par des cercles vides.
Résultats de l’étude
Un seul tableau ECoG a capturé les représentations neuronales de plusieurs effecteurs. Les HGA associés aux mouvements oro-faciaux liés aux mains, aux bras, à la tête, aux yeux et à la parole ont montré une large organisation somatotopique à travers le SMC, le degré de séparation variant selon les participants. L’activité liée à la parole et aux gestes était la plus forte dans le gyrus précentral, avec une activité de parole plus ventrale et une activité gestuelle plus dorsale.
Les performances du décodeur dépendaient du contexte comportemental. Les modèles formés uniquement sur des essais isolés de parole ou de gestes ne se sont pas complètement généralisés aux tentatives simultanées de parole et de gestes. Avec la plus grande taille de formation partagée, les modèles formés sur des essais simultanés ont obtenu de meilleurs résultats sur des tests simultanés, tandis que les modèles formés de manière isolée ont obtenu de meilleurs résultats sur des tests isolés.
Les modèles hybrides formés sur des données isolées et simultanées ont maintenu une grande précision dans tous les contextes et ont surpassé les modèles formés sur un seul contexte. Les modèles de contribution des électrodes ont changé avec le contexte de formation, les modèles s’appuyant généralement sur des électrodes présentant un chevauchement parole-geste plus faible.
Dans l’analyse sans intervention Bravo-6, la précision médiane des gestes était de 65,8 % pour les paires vues et de 66,7 % pour les paires invisibles ; la précision de la parole était respectivement de 79,3 % et 80,0 %. Dans le cadre de cette analyse, ni la précision de la parole ni celle des gestes ne différaient de manière significative entre les paires considérées comme naturelles ou non naturelles dans la conversation. Au cours des tests longitudinaux, la précision est restée supérieure au hasard au fil des jours, voire des mois, avec une stabilité variable selon les participants et les modalités ; les données d’entraînement plus récentes ont généralement amélioré les performances ultérieures.
Avant la formation multi-modalités, les taux médians de faux positifs pour les modalités opposées (FPR) étaient de 30,6 % pour Bravo-6 et de 76,0 % pour Bravo-1r. L’entraînement multimodal a réduit les deux à 0,0 % tout en maintenant un FPR faible pendant le vrai repos. Les modèles formés sur des comportements isolés et simultanés ont également maintenu de faibles taux de faux négatifs (FNR) dans les deux contextes, réduisant ainsi la tendance à classer à tort les tentatives de parole ou de gestes comme du repos.
En utilisant tous les ensembles de données disponibles avec une formation multimodale, la précision moyenne du décodage simultané hors ligne pour Bravo-6 était de 68,8 % pour les gestes et de 77,5 % pour la parole. Pour Bravo-1r, les précisions correspondantes étaient de 88,3 % et 84,0 %. Dans la tâche de copie gestuelle uniquement, la précision était de 81,8 % pour Bravo-6 et de 61,7 % pour Bravo-1r.
Lors du décodage simultané en temps réel dans Bravo-6, la précision était de 66,0 % pour les gestes et de 70,0 % pour la parole. Dans le paradigme de conversation, Bravo-6 a atteint une précision moyenne de 85,0 % pour les gestes et de 75,0 % pour la parole, tandis que Bravo-1r a atteint une précision médiane de 100,0 % pour les deux.
Ce test conversationnel de validation de principe était limité à cinq blocs de quatre essais pour Bravo-6 et à trois blocs de trois essais pour Bravo-1r. La parole décodée apparaissait sous forme de texte, tandis que les gestes décodés animaient l’avatar, permettant la parole seule, les gestes seuls ou les deux lors d’une interaction virtuelle.
Conclusions
Les résultats fournissent la preuve de concept selon laquelle un seul implant ECoG haute densité peut décoder simultanément la parole et les gestes chez deux personnes atteintes de paralysie sévère. Le tableau a capturé des représentations neuronales distinctes mais se chevauchant partiellement à travers la parole et les mouvements corporels.
Les modèles de formation avec des comportements à la fois isolés et simultanés ont amélioré la généralisation dans tous les contextes, tandis que la formation multi-modalités a réduit les fausses activations. Le système prenait également en charge le contrôle en temps réel d’un avatar personnalisé complet lors des tâches de copie et de conversation.
Ces résultats fournissent une preuve de concept pour les BCI multi-effecteurs prenant en charge une communication plus expressive. La première étude de faisabilité impliquait trois participants au total, avec un décodage simultané de la parole et des gestes testé chez deux d’entre eux à l’aide de vocabulaires restreints et de tâches structurées, et des tests conversationnels limités à un petit nombre d’essais.
Des recherches supplémentaires sont nécessaires pour déterminer si la parole et les gestes peuvent être décodés de manière fiable lorsqu’ils sont utilisés ensemble.
