Dans une étude récente publiée dans la revue Intelligence des machines naturellesles chercheurs ont développé « DeepGO-SE », une méthode permettant de prédire les fonctions d’ontologie génique (GO) à partir de séquences protéiques à l’aide d’un grand modèle de langage protéique pré-entraîné.
Étude : Prédiction de la fonction des protéines comme implication sémantique approximative. Crédit d’image : DarwinAmelie/Shutterstock
Bien que la prédiction de la structure des protéines soit devenue de plus en plus précise au fil des années, la prédiction de la fonction des protéines reste un défi en raison du nombre limité de fonctions connues, aggravé par leurs interactions et leur complexité. Les GO sont utilisés pour décrire les fonctions des protéines. GO comprend trois sous-ontologies décrivant les fonctions moléculaires (MFO) des protéines, leur rôle dans les processus biologiques (BPO) et les composants cellulaires (CCO) où elles sont actives.
Une limitation significative de plusieurs méthodes de prédiction de fonctions est leur dépendance à la similarité de séquence. Bien qu’efficace pour les protéines ayant des séquences similaires et des fonctions bien caractérisées, cette approche est moins fiable pour celles qui n’ont pas ou peu de similarité de séquence. De plus, les fonctions des protéines dépendent principalement de leur structure, et des protéines ayant des structures similaires pourraient avoir des séquences différentes.
Les connaissances de base contenues dans les axiomes des GO peuvent être exploitées grâce à des modèles d’apprentissage automatique pour améliorer les prédictions. Il n’existe que quelques méthodes qui utilisent les axiomes formels des GO. Les méthodes de classification hiérarchique, telles que DeepPred, TALE, DeepGO et GOStruct2, utilisent des axiomes de subsomption mais en ignorent d’autres qui pourraient être utilisées pour limiter l’espace de recherche et améliorer les prédictions.
L’étude et les résultats
Dans la présente étude, les chercheurs ont développé une méthode de prédiction de la fonction des protéines, DeepGO-SE, en utilisant un grand modèle de langage protéique pré-entraîné. DeepGO-SE a mis en œuvre un apprentissage amélioré par les connaissances grâce à l’implication sémantique en trois étapes. Tout d’abord, un modèle approximatif a été généré à l’aide d’ELEmbeddings, basé sur une théorie logique composée d’axiomes GO (connaissances de base) et d’affirmations sur les protéines telles que « la protéine a une fonction C ».
Ensuite, des protéines uniques ont été représentées par des intégrations du modèle à l’échelle évolutive 2 (ESM2) et utilisées comme instances dans le modèle approximatif pour maximiser la vérité de l’assertion en tant qu’objectif d’optimisation. Finalement, cette procédure a été répétée pour générer k modèles approximatifs ; l’implication a été définie comme la vérité dans tous les modèles, et le k des modèles ont été utilisés pour une implication sémantique approximative.
Les chercheurs ont comparé leur méthode à cinq méthodes de base utilisant un ensemble de données UniProtKB/Swiss-Prot. Les méthodes de base étaient l’approche naïve, le perceptron multicouche (MLP), DeepGraphGO, DeepGoZero et DeepGOCNN. Les sous-ontologies GO ont été formées et évaluées séparément. DeepGO-SE a largement surpassé les méthodes de base.
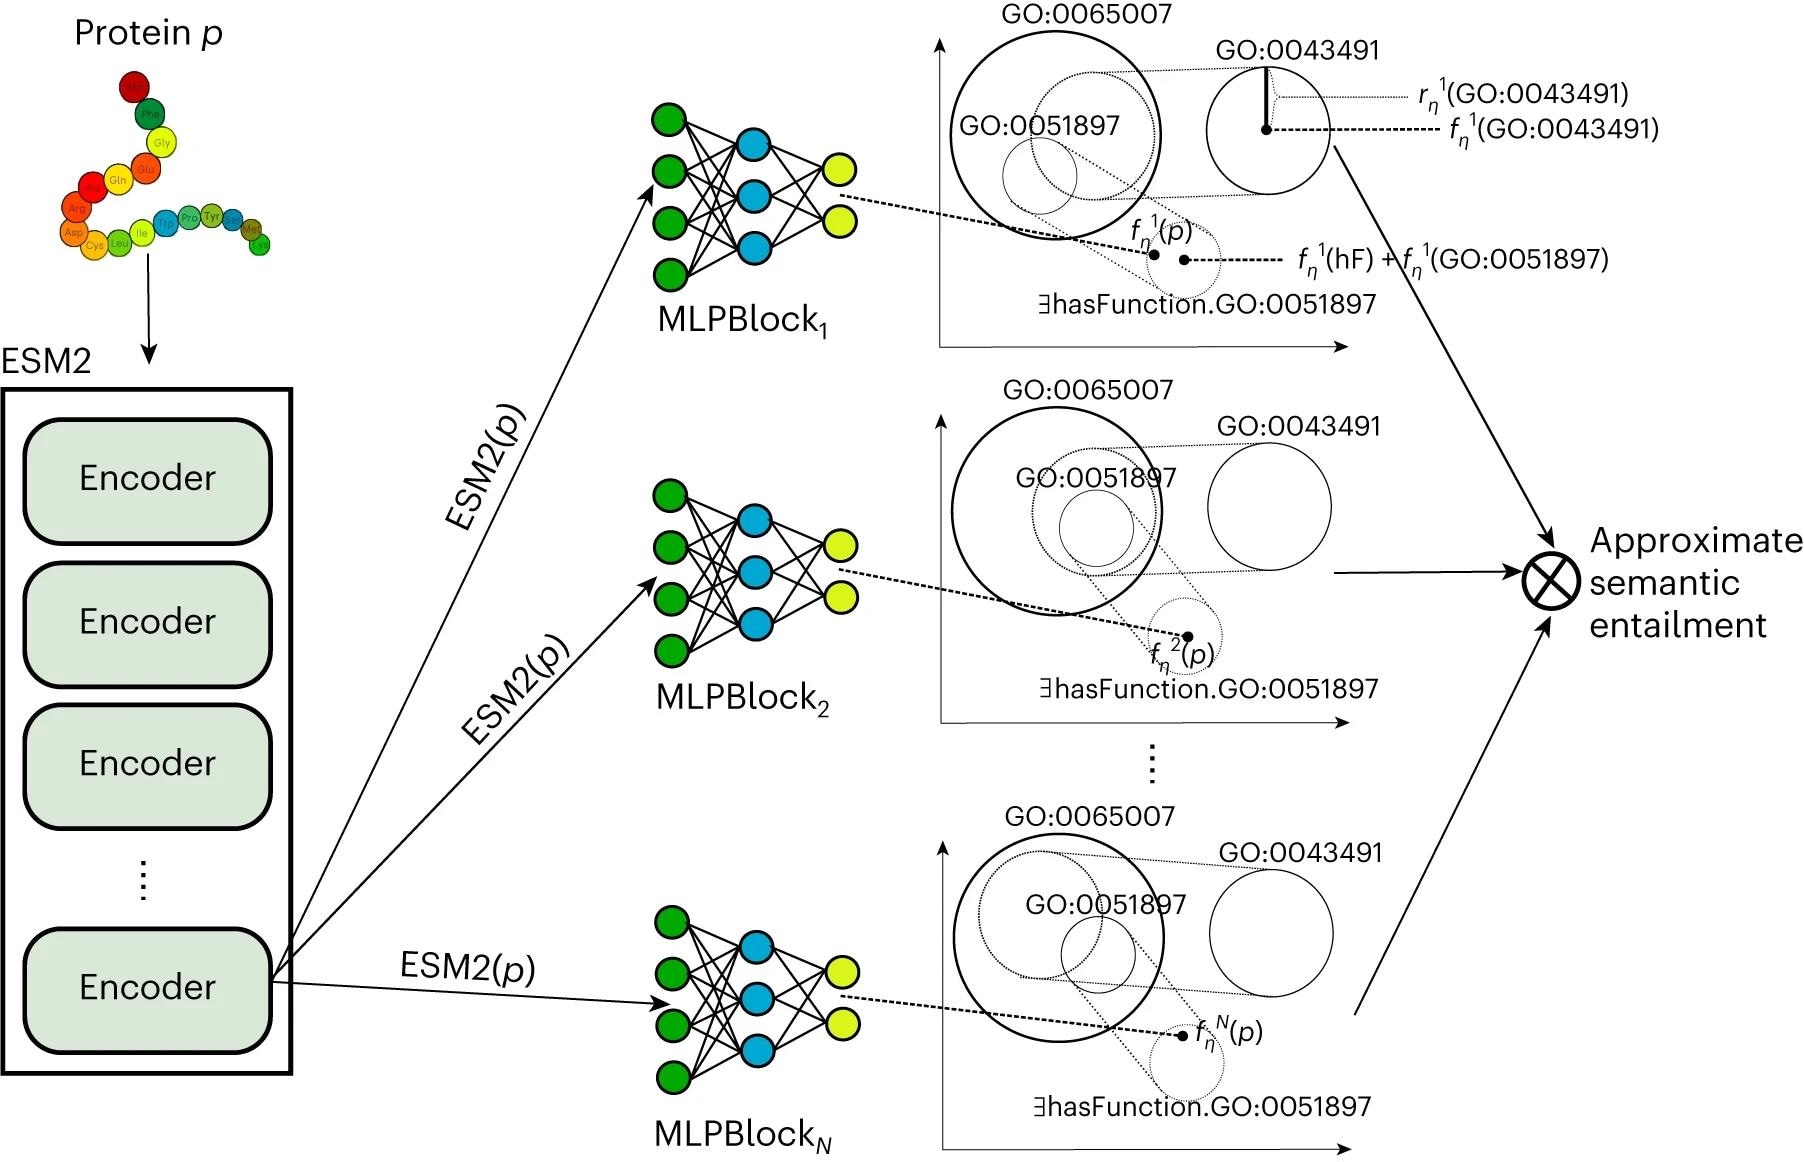
Gauche : la protéine p est intégrée dans un espace vectoriel à l’aide du modèle ESM2. À droite : plusieurs modèles avec un MLP qui intègre la protéine dans le même espace que les axiomes GO. De plus, les prédictions de plusieurs modèles sont combinées pour effectuer une implication sémantique approximative.
En MFO, la mesure F maximale (F max) de DeepGO-SE était de 0,554, soit 7 % de plus que celle des méthodes DeepGoZero et MLP. En BPO, c’est F max (0,432) était 8 % plus élevé que DeepGraphGO. En CCO, DeepGO-SE a réalisé un F maximum de 0,721. Ensuite, l’équipe a modifié les incorporations de protéines pour coder des informations supplémentaires concernant le protéome et ses interactions.
À cette fin, les vecteurs d’entrée de DeepGO-SE ont été modifiés et trois expériences ont été réalisées. Premièrement, les intégrations ESM2 ont été utilisées comme entrée pour chaque protéine dans DeepGOGAT-SE. Ensuite, des annotations expérimentales d’une protéine sur des fonctions moléculaires ont été utilisées comme entrée dans DeepGOGATMF-SE. Enfin, les scores de prédiction dérivés du modèle DeepGO-SE pour les fonctions moléculaires ont été utilisés comme entrée dans DeepGOGATMF-SE-Pred.
La combinaison des intégrations ESM2 et des interactions protéine-protéine (IPP) dans DeepGOGAT-SE a diminué les performances de la prédiction MFO (F max : 0,525) mais améliore légèrement la distance sémantique minimale (S minutes). De plus, la prédiction du BPO a été améliorée (F maximum : 0,435). Notamment, les meilleures performances BPO ont été observées avec DeepGOGATMF-SE (F max : 0,448), suivi de DeepGOGATMF-SE-Pred (F maximum : 0,444). L’intégration des PPI dans DeepGO-SE a augmenté le F maximum pour les CCO à 0,736.
L’équipe a également évalué ses méthodes de base à l’aide de l’ensemble de données neXtPro (des fonctions protéiques prédites manuellement). Ils ont constaté que DeepGO-SE avait obtenu le meilleur F maximale (0,386). DeepGOGAT-SE a obtenu les meilleurs résultats pour les BPO, avec un F maximum de 0,35. L’équipe n’a pas pu évaluer la méthode DeepGOGATMF-SE-Pred car de nombreuses protéines manquaient de fonctions moléculaires manuelles.
Enfin, une étude d’ablation a été réalisée pour évaluer la contribution des composants individuels des modèles. Les fonctions de perte d’axiome ELEmbeddings ont été supprimées pour chaque modèle et la perte de prédiction de fonction a été optimisée. La suppression des pertes d’axiome de DeepGO-SE a réduit les performances MFO sans affecter les performances BPO et CCO.
Dans DeepGOGAT-SE, la suppression des axiomes et des modules d’implication sémantique a légèrement amélioré les performances de MFO mais a réduit celles de BPO et CCO. Les performances du BPO et du CCO étaient meilleures lorsque les axiomes et les implications sémantiques étaient supprimés dans les modèles utilisant des fonctions moléculaires et des IPP comme caractéristiques.
Conclusions
Dans l’ensemble, DeepGO-SE est une méthode améliorée de prédiction de la fonction des protéines qui intègre des caractéristiques de séquence dérivées d’un modèle de langage protéique pré-entraîné, des connaissances de base de GO et des IPP. Il peut prédire le BPO et le CCO à partir d’une seule séquence protéique ; cependant, les informations PPI étaient nécessaires pour obtenir de meilleurs résultats. Étant donné que de nombreuses nouvelles protéines n’ont pas d’interactions connues, des méthodes permettant de prédire les interactions des nouvelles protéines à partir de leur séquence uniquement sont nécessaires.
