
Une étude historique exploite le séquençage à lecture longue pour révéler de vastes variations structurelles non détectées dans l'ADN humain, remodelant notre compréhension de la génétique et du potentiel de la maladie.
Étude: variation structurelle chez 1 019 humains diversifiés basés sur le séquençage à longue lecture
Dans une étude récente publiée dans la revue Natureles chercheurs ont étudié les variantes structurelles à grande échelle (SV), les insertions, les suppressions et les réarrangements complexes et mal compris dans l'ADN, en utilisant le séquençage à longue lecture de nouvelle génération. Leur ensemble de données révolutionnaire comprenait 1 019 individus dans 26 populations mondiales. L'étude a en outre modéré un nouveau cadre analytique basé sur des graphiques, permettant la création de plus de 107 000 SV bialléliques résolus par séquence, que les auteurs ont réalisé.
L'enquête génomique à haute résolution ne fait pas seulement de manière significative notre compréhension de la véritable diversité de la génétique humaine, mais progresse également notre identification et notre gestion future des variantes génétiques pathogènes chez les patients.
Sommaire
Arrière-plan
Les manuels de biologie dépeignent souvent le génome humain comme une chaîne linéaire de trois milliards de combinaisons de A, T, G et C – notre ADN, les éléments constitutifs de notre vie. La réalité, cependant, est beaucoup plus dynamique, notre ADN démontrant des variantes structurelles à grande échelle (SV) – d'élétions, de duplications, d'insertions et d'inversions de segments d'ADN entiers.
Malgré la prise en compte de la plupart des différences de paire de base (BP) entre deux organismes et des contributeurs majeurs et des modulateurs de la santé humaine, ils restent notoirement difficiles à étudier et mal comprises. Le séquençage à lecture courte, la technologie de séquençage prédominante d'aujourd'hui, épissant de longs segments d'ADN en minuscules fragments, qui sont ensuite amplifiés. Bien que efficaces pour les petites variantes, ces technologies ont du mal à cartographier les SV complexes, en particulier les insertions importantes et les répétitions en tandem de nombre variable multiallélique (VNTR), qui sont parfois complètement manquées.
Par conséquent, une grande majorité du génome humain reste invisible à la science et à la médecine, permettant aux maladies génétiques potentiellement curables de persister sans relâche. Le séquençage à longue lecture est une technologie relativement nouvelle qui peut lire beaucoup plus longtemps et des étirements continus d'ADN, surmontant ainsi la principale lacune associée au séquençage à lecture courte. L'apparition de cette technologie pourrait débloquer cette partie cachée du génome humain et des trésors médicaux qui se trouvent à l'intérieur.
À propos de l'étude
Le présent travail fait exactement ceci: un consortium de chercheurs a entrepris un projet multinational massif pour cartographier les SV en utilisant une cohorte mondiale diversifiée. Des échantillons d'étude ont été acquis à partir du projet 1000 Genomes (1kGP) et comprenaient initialement 1 064 échantillons (lignées cellulaires lymphoblastoïdes).
Un contrôle de qualité strict (QC) en utilisant une combinaison de détermination de la concentration d'ADN (lecteur de microplaques multimode), d'évaluation de la pureté de l'ADN (spectrophotomètre) et de vérification de la longueur des fragments d'ADN (système d'impulsion FEMTO) a réduit l'ensemble de données à 1 019. Cet ensemble de données comprenait des participants de 26 ancêtres distincts à travers l'Afrique, les Amériques, l'Europe et l'Asie de l'Est et du Sud.
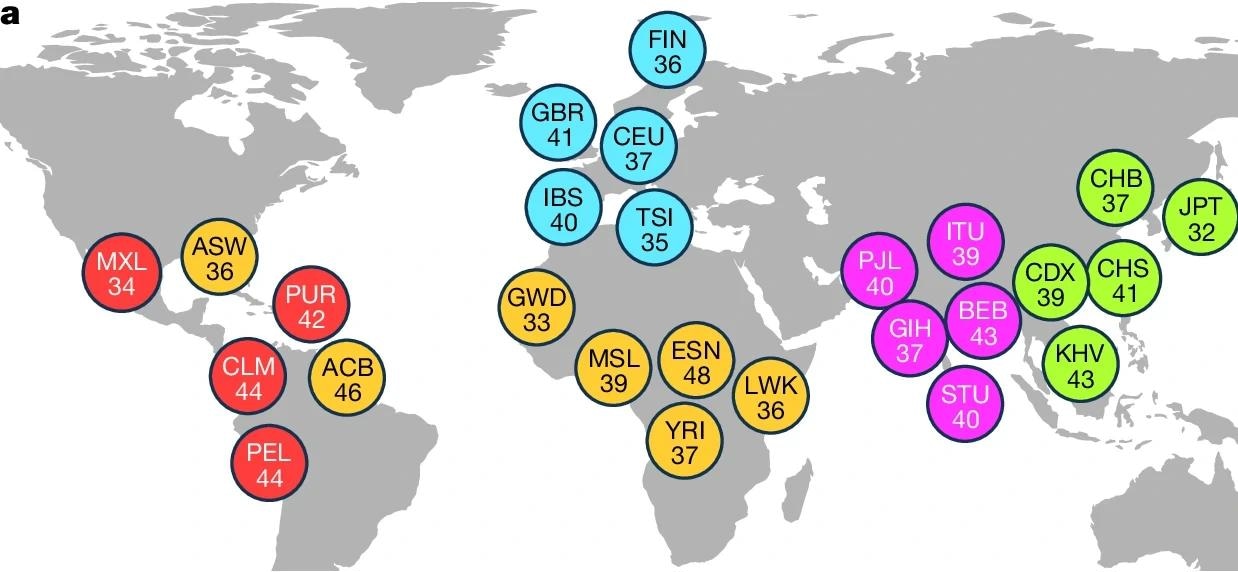
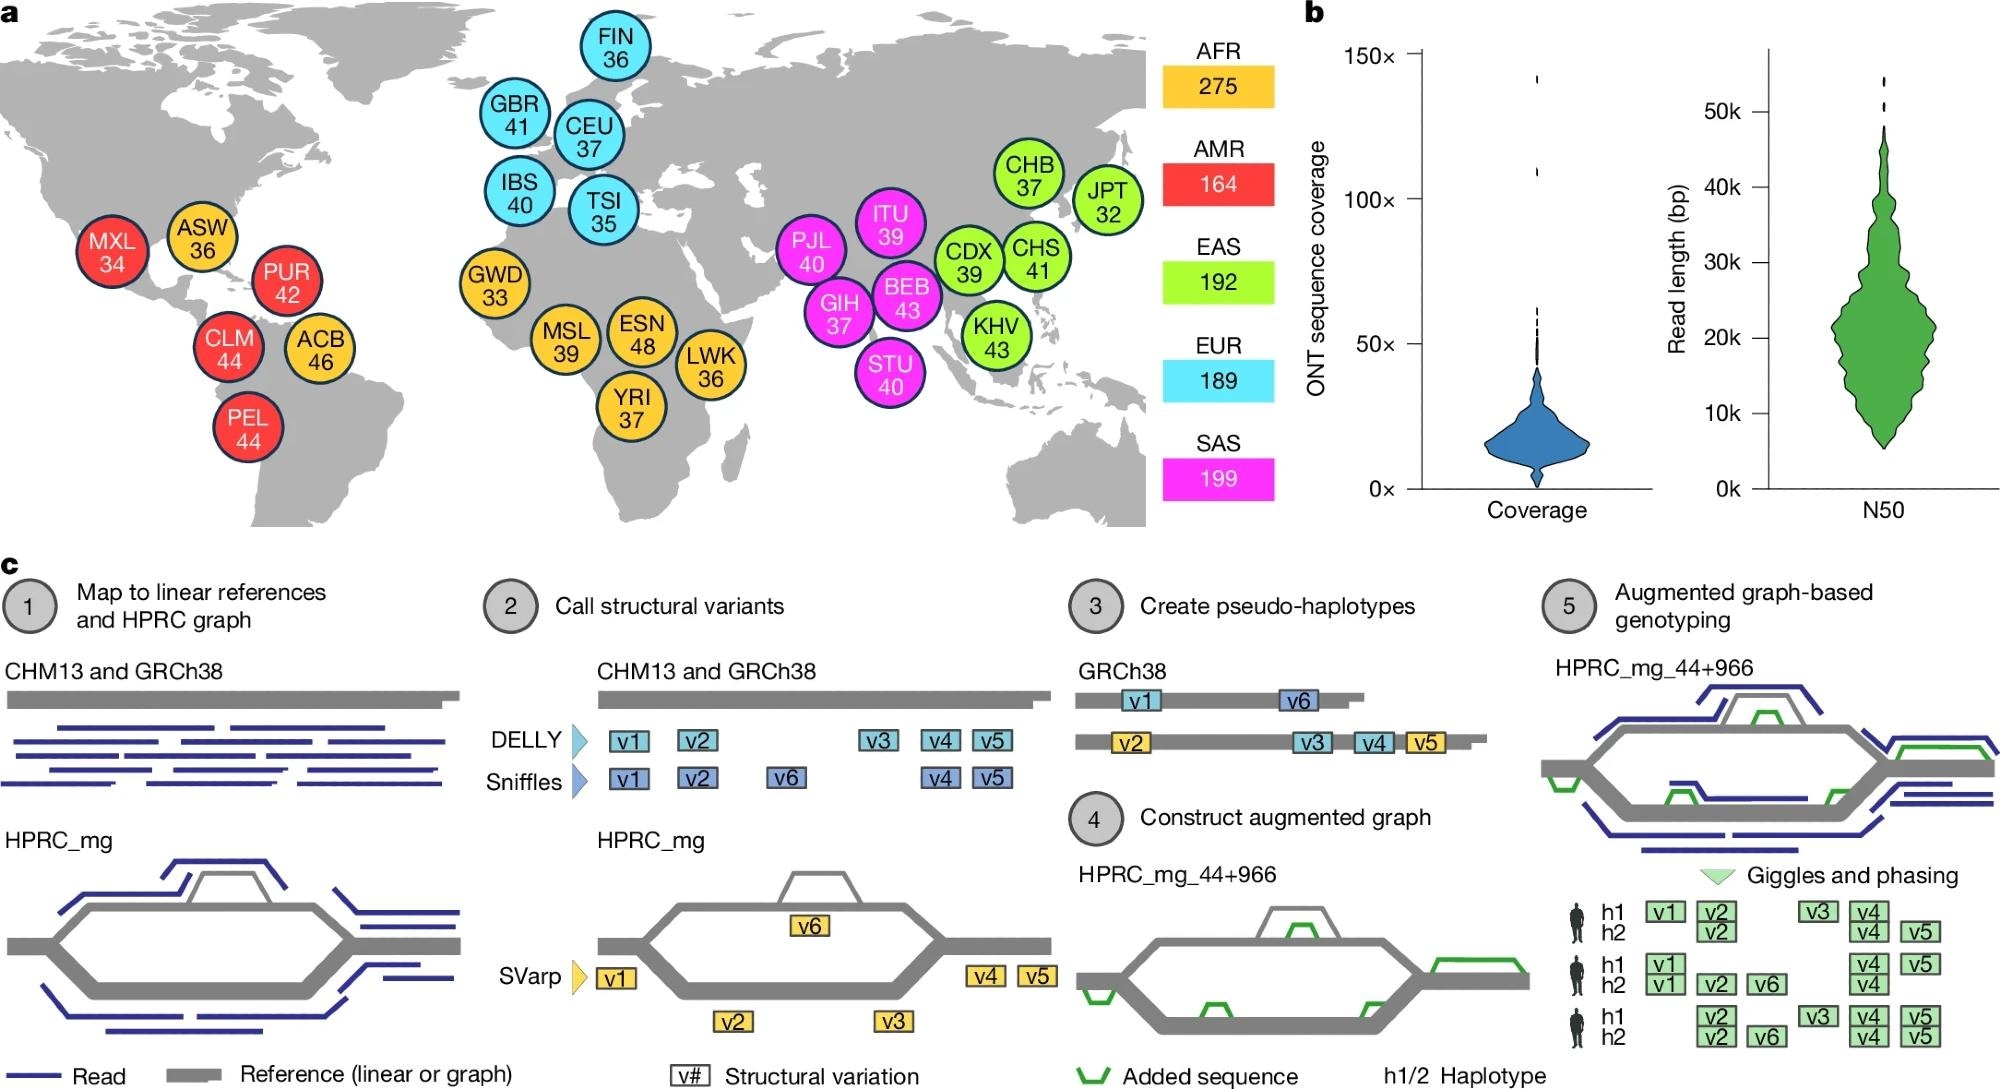 unDéchange des ancêtres géographiques auto-identifiées pour 1 019 génomes à lecture longue représentant 26 géographies (c'est-à-dire les populations) de 5 régions continentales. Les codes à trois lettres utilisés sont équivalents à ceux utilisés dans la phase III 1kgp18 et sont résolus dans un tableau supplémentaire 2. bCouverture de séquence ONT par échantillon, exprimée en couverture de pli (à gauche), et la longueur de lecture N50 en paires de bases (à droite). cSchéma du cadre SAGA pour la découverte et le génotypage de Graph-Aware of SVS à l'aide d'une approche d'augmentation du graphique de Pangenome. BaseMap dans un à partir des données de terre naturelle (https://www.naturalearthdata.com).
La plate-forme de séquençage à longue lecture utilisée était la LRS Oxford Nanopore Technologies (ONT), une technologie de pointe capable de générer des données avec une longueur de lecture médiane de plus de 20 000 paires de bases.
Pour analyser cet ensemble de données complexes, ils ont conçu un nouveau cadre de calcul appelé SAGA (analyse SV par augmentation graphique). Ce processus impliquait quatre étapes clés: d'abord, l'alignement de lectures longues sur les références linéaires (GRCH38) et basées sur des graphiques (HPRC); Deuxièmement, SV Discovery Utilisation de Sniffles, Delly et de l'algorithme SVARP Aware-Aware Graph, y compris des remappage spécialisés pour résoudre les artefacts d'alignement d'inversion; Troisièmement, augmenter le graphique de Pangenome pour incorporer de nouveaux SV malgré les complexités du génotypage VNTR multiallélique; et enfin, le génotypage de la cohorte à l'aide du logiciel de rires pour déterminer les transporteurs variants (n = 967 échantillons), notant que les sites multialléliques ont montré une incohérence mendélienne plus élevée (15,1%).
Résultats de l'étude
La présente étude a abouti à la production d'un catalogue de plus de 100 000 SV à résolution résolue à plus de 100 000 SV (Biallelic), aux côtés de 369 685 Nombre de variables de variable multiallelique (VNTR) génotypés à l'aide de l'outil Vamos. Les SV identifiés comprenaient les inversions, les suppressions, les duplications et les insertions, totalisant une augmentation plus que dix du nombre de sites d'insertion entièrement résolus, comblant une lacune critique dans les connaissances génomiques humaines.
Des expériences de cohérence mendélienne tirant parti des trios familiaux (deux parents et un enfant) au sein de la cohorte ont démontré la précision élevée de l'étude et le taux d'erreur extrêmement faible (suppressions et insertions à seulement 3,87% et 4,44%, respectivement) pour les SV bialléliques. Notamment, la plupart des nouveaux SV identifiés dans cette étude se sont révélés extrêmement rares, 59,3% ayant une fréquence d'allèle mineure (MAF) de moins de 1%. Les individus d'origine africaine ont démontré le plus haut degré de diversité SV.
Enfin, l'étude a fourni de nouvelles informations sur les mécanismes biologiques qui créent des SV, détaillant comment les éléments d'ADN mobiles, tels que L1 et les rétrotransposons SVA, conduisent l'innovation génétique en favorisant la formation et la translocation des SV via des processus source spécifiques au locus, y compris le détournement de promoteur (EG, l'élément source 8q21.11 L1).
Conclusions
La présente étude représente un bond louable en avant dans nos connaissances et notre compréhension de la génomique humaine. L'application du séquençage à lutte longue permettait avec succès la découverte et l'annotation de plus de SV (en particulier les insertions), et la diversité de la cohorte de l'échantillon (26 ancêtres distinctes sur plusieurs continents) valide la généralisabilité et l'application globale des résultats de l'étude.
De plus, l'atlas SV complet et précis qui en résulte, étant en libre accès, ouvre les portes à une nouvelle ère de médecine génétique, permettant l'identification et le traitement précoce des conditions génétiques que nous ne connaissions qu'à présent, existait. Notamment, lorsqu'il est appliqué aux génomes de la maladie rare, la ressource a filtré 55% des SV candidats tout en conservant 94% (35/37) des variantes causales validées. Cette ressource en libre accès sera inestimable pour la communauté scientifique, permettant une compréhension plus profonde de l'évolution humaine, de la génétique de la population et des conséquences fonctionnelles de la variation génétique.
